Prototyper une plateforme de veille info avec Lumo AI (Proton) : retour d'expérience
L’IA générative offre des perspectives très intéressantes aux professionnels de la veille informationnelle, notamment celle de pouvoir concevoir sur mesure un moteur de collecte et de traitement de l’information en ligne qui puisse refléter leurs propres grilles d’analyse. Débutants dans le domaine de la veille informationnelle et armés de bases rudimentaires en développement informatique, c’est le défi que nous nous sommes lancé : prototyper une plateforme de veille informationnelle grâce à l’assistant confidentiel Lumo AI, développé par Proton AG. Cet article en restitue le retour d’expérience1.
Quelques façons de tirer parti de l’IA générative dans le domaine de la veille informationnelle
Dissiper le nuage informationnel à l’aide des flux web combinés aux grands modèles de langage
Avec les développements récents des grands modèles de langage (ou Large Language Model, LLM), on observe un regain d’intérêt pour les flux web (RSS, Atom, JSON) dans le domaine de la veille informationnelle.
Bien sûr, les professionnels de la veille n’ont pas attendu cette innovation technologique pour exploiter les informations publiées dans ce format de données né avec le web ; le plus souvent au moyen d’agrégateurs de flux qui ont été développés dans le sillage de Google Reader au milieu des années 2000.
Cependant, la démocratisation des grands modèles linguistiques accroît la capacité du « veilleur » à cibler, plus finement qu’avec de simples mots-clés, l’information utile et isolée au milieu du bruit médiatique publié quasi continûment dans ces flux. Il peut ainsi choisir comment et d’après quels critères, les informations collectées directement auprès de l’émetteur sont filtrées, classifiées, recoupées, enrichies et mises en avant dans son fil d’actualité.
L’usage d’un LLM à cet effet n’est, bien entendu, pas exempt de tout biais ; mais cette approche peut aider à contourner les algorithmes des « plateformes publicitaires » qui sont, à dessein, programmés pour orienter le clic du consommateur vers les contenus susceptibles de générer le plus de revenus publicitaires.
Coder sa propre plateforme de veille informationnelle grâce à l’IA générative
Les performances démontrées récemment par les IA génératives ont eu pour effet d’abaisser la barrière d’accès à la programmation informatique : avec un minimum de culture dans ce domaine, tout un chacun est désormais capable de faire développer, via un assistant IA, son propre logiciel — dans ce cas de figure, nous ne saurions trop recommander de faire auditer ces développements par un professionnel.
Dès lors, si l’objectif du veilleur est de maîtriser le circuit de traitement de l’information en ligne, celui-ci ne pourrait-il pas coder sa propre plateforme de veille informationnelle au lieu de dépendre d’une application tierce ?
Cette idée est particulièrement séduisante lorsque, en plus de se préserver des bulles filtrantes, le spécialiste de la veille se préoccupe aussi de la confidentialité des données qu’il génère ; en particulier lorsque celui-ci travaille pour un client qui souhaite masquer ses intentions à des tiers, alors même qu’il est susceptible de les divulguer, malgré lui, à travers les informations qu’il recherche, filtre et recoupe.
Toutefois, à l’instar des plateformes publicitaires, les grandes plateformes de l’IA ne sont pas en reste en matière de confidentialité des données : leur modèle économique repose aussi sur une stratégie d’influence marketing, rendue possible par l’exploitation de mécanismes cognitifs plus élaborés encore que le conditionnement béhavioriste exploité jusque-là par les réseaux sociaux.
L’outsider Lumo, l’assistant IA confidentiel développé par Proton AG
Afin de prendre le contre-pied de ce modèle économique fondé sur l’exploitation des données personnelles, l’entreprise Proton AG, déjà connue pour son engagement en faveur du respect de la vie privée sur internet, a sorti en juillet 2025 son propre assistant IA, dénommé Lumo.
Cet assistant multimodal s’appuie sur plusieurs LLM accessibles en source ouverte, exécutés sur les serveurs de calcul de Proton et orchestrés de manière à fournir aux utilisateurs des réponses optimisées à leurs requêtes. Proton assure ne conserver aucun historique des conversations sur ses serveurs, ni de vendre les données d’utilisateurs, ni de les utiliser afin d’entraîner ses modèles.
Lumo est, à l’heure actuelle, capable d’effectuer des recherches sur internet, de générer du texte et de produire ou modifier des images. Depuis la version 2.0 sortie le 30 juin 2026, l’utilisateur peut aussi choisir entre deux modèles (« Lite » pour les requêtes du quotidien et « Max » pour les tâches complexes) et deux modes de réponse (« Fast » pour une réponse brève ou « Thinking » pour un argumentaire plus étayé). Selon Proton, sur l’indice Artificial Analysis Intelligence — un benchmark indépendant combinant dix évaluations portant sur les agents, la programmation, le raisonnement scientifique et la culture générale —, Lumo 2.0 Lite obtiendrait un score supérieur de 127 % à celui de Lumo 1.4, et Lumo 2.0 Max de 240 %. Des données que le présent retour d’expérience nous permettra de confronter à la pratique.
Cependant, Lumo n’est pas encore pleinement intégré à l’écosystème de Proton. Par exemple, l’assistant IA ne sait pas lire ou éditer les fichiers de texte édités avec Proton Docs. Lumo n’est pas non plus complètement synchronisé avec Proton Drive, car chaque fichier stocké sur le serveur de stockage doit être ajouté manuellement dans son interface de chat. Par ailleurs, aucune API officielle n’est pour l’instant disponible. Enfin, à notre connaissance, nous ne disposons d’aucun retour d’expérience sur l’efficacité de Lumo dans le domaine de l’informatique (architecture, programmation, etc.).
En dépit de ces quelques limites, nous avons choisi de tester Lumo pour concevoir notre infrastructure de veille informationnelle, en raison de la réputation dont dispose Proton en matière de protection de la vie privée sur internet, et pour les garde-fous en matière de chiffrement des conversations que l’entreprise a spécifiquement pensé pour Lumo AI.
Retour d’expérience avec Lumo AI
Ces tests ont été menés, par petites touches, du 12/05/2026 au 04/09/2026. Tous les développements ont donc été initiés avec Lumo 1.4, et les derniers tests ont été réalisés avec Lumo 2.0 Max (mode « Thinking »). Dans les lignes qui suivent, nous renseignons systématiquement la version qui a été utilisée pour chaque test unitaire. De plus, lorsque des limites techniques ont été rencontrées avec Lumo 1.4, nous nous sommes efforcés de vérifier, a posteriori, si des améliorations étaient obtenues avec Lumo 2.0.
Lumo l’architecte
Nous avons d’abord demandé à Lumo 1.4 de concevoir l’architecture de notre plateforme de veille, sur la base des besoins fonctionnels suivants :
- Un moteur métier centré sur l’extraction de flux web, envoyés à une IA générative chargée de cibler2 les informations les plus pertinentes concernant un thème prédéfini.
- Une interface homme-machine, permettant à l’utilisateur de formuler une requête à l’IA générative et de recevoir une réponse en retour.
- Une architecture client-serveur, où les requêtes sont envoyées depuis un ordinateur de travail, tandis que le stockage des données et les opérations « lourdes » (vectorisation, inférence) sont pris en charge par un ou plusieurs serveurs distants.
- Le chiffrement des données qui transitent entre le PC client et le ou les serveurs.
Par ailleurs, nous lui avons demandé de distinguer deux scénarios : une solution « 100% locale » (via un vieux PC Windows 10 recyclé en serveur pour les besoins de la démonstration) et une solution « cloud ».
| Aspect | Solution 100% Locale (Ollama) | Solution cloud (Lumo + Proton Drive) |
|---|---|---|
| Stockage | Sur votre disque dur (chiffré par OS) | Proton Drive (Chiffré E2EE par Proton) |
| Traitement (LLM) | Sur votre CPU/GPU (Aucune donnée ne sort) | Sur les serveurs de Proton (Données déchiffrées temporairement pour l’inférence) |
| Traitement (Embeddings) | Sur votre machine | Sur les serveurs de Proton (ou via API si vous gérez les vecteurs) |
| Confidentialité | Absolue (Même Proton ne voit rien) | Très élevée (Proton ne peut pas lire vos fichiers stockés, mais doit les déchiffrer pour vous faire répondre) |
| Ressources | Nécessite une machine puissante (RAM/GPU) | Aucune ressource locale nécessaire (Cloud) |
Après quelques prompts itératifs, l’assistant IA a d’abord formulé deux solutions techniques conformément à notre demande (Tableau 1), puis a suggéré une troisième option qualifiée « d’hybride », consistant à réaliser un pré-traitement des flux web localement, puis de gérer l’inférence sur le cloud (Tableau 2).
| Étape | Où ça se passe ? | Pourquoi ? | Impact Confidentialité |
|---|---|---|---|
| 1. Ingestion & Nettoyage | Local (votre machine) | Léger, ne demande pas de GPU. | ✅ 100% privé |
| 2. Génération Embeddings | Local (CPU léger) | Les modèles d’embedding (ex : MiniLM) sont très légers (quelques Mo, quelques secondes). | ✅ 100% privé (les vecteurs ne sortent pas) |
| 3. Stockage Vectoriel | Local (ChromaDB) | Stockage sur disque, très peu de RAM requise. | ✅ 100% privé |
| 4. Recherche (Retrieval) | Local | Trouve les 3-5 meilleurs chunks pertinents. | ✅ 100% privé |
| 5. Envoi à Lumo | Cloud (Lumo) | Seulement les 3-5 chunks pertinents (quelques centaines de mots) sont envoyés, pas toute la base. | ⚠️ Minimisé (seul le contexte nécessaire est exposé) |
| 6. Réponse (LLM) | Cloud (Lumo) | Lumo génère le résumé. | ⚠️ Minimisé |
Pour la solution cloud, l’assistant nous a donc, sans surprise, proposé une architecture 100% Proton, combinant Lumo pour l’inférence et Drive pour le stockage, sans toutefois préciser où doit se dérouler l’ingestion des flux web.
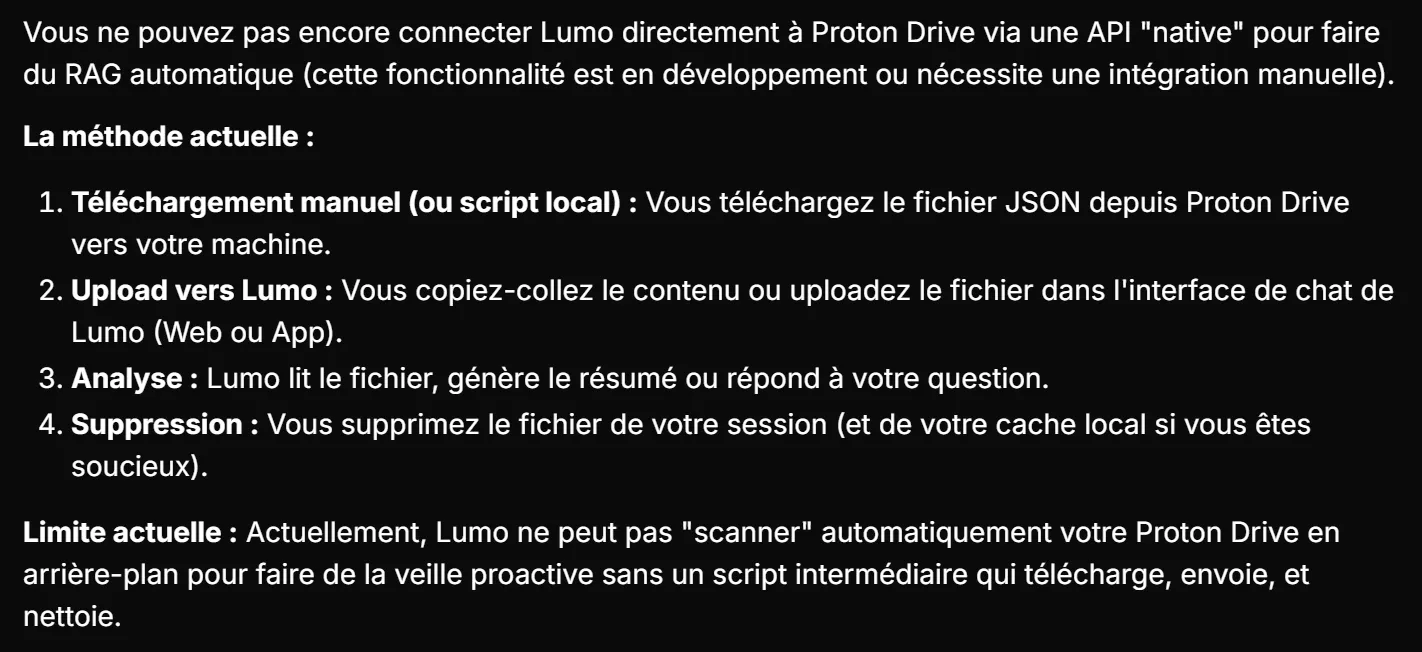
On relève à propos de cette architecture une première « hallucination » de l’assistant IA (corrigée dans la suite de sa réponse, cf. Figure 1), qui suggère l’existence d’une API Lumo native. Or, nous l’avons évoqué en introduction, il n’en existe aucune à l’heure actuelle. De plus, l’intégration encore restreinte de Lumo dans l’écosystème de Proton nécessite de transférer manuellement les fichiers depuis le Drive vers l’interface de chat de l’assistant. Ces deux limites techniques réduisent donc considérablement l’intérêt des options cloud et hybride pour notre cas d’usage.
Quant à l’option 100% locale, Lumo a fourni en complément des tableaux précédents, un diagramme ASCII de l’architecture cible du système de veille (Listing 1). Dans les grandes lignes, la solution technique repose sur les briques suivantes :
- L’extraction de flux web est confiée à un script Python, exécuté sur le serveur de veille.
- La fenêtre de chat de la plateforme OpenWebUI joue le rôle d’interface homme-machine.
- Le moteur IA est le modèle Mistral 7B, orchestré par la plateforme d’IA Ollama.
- La communication entre le client et le serveur est chiffrée grâce à un réseau privé virtuel (ou Virtual Private Network, VPN), créé par le logiciel Tailscale. Ce dernier doit constituer le seul point d’entrée du système de veille.
Sur le plan architectural, la solution proposée est globalement cohérente, et elle répond aux besoins fonctionnels exposés ci-dessus. Cependant, en analysant le diagramme ASCII en détail, on note plusieurs approximations graphiques, et certains choix techniques nous questionnent. Entre autres choses :
- Les flux d’informations transitent uniquement du serveur vers le client, alors que la requête de l’utilisateur doit partir du client pour aller vers le serveur.
- La flèche horizontale « Requêtes/Réponses » ne traverse pas le bloc « Réseau privé », ce qui est une erreur puisque tous les flux doivent être chiffrés.
- La représentation du VPN sécurisé, dupliquée à l’intérieur et à l’extérieur du bloc « Serveur », est confuse.
- Les échanges client-serveur passent, en principe, exclusivement par l’intermédiaire d’OpenWebUI. Or, à part la mention « Input: Question Utilisateur » dans le bloc 3, qui est d’ailleurs improprement dénommé « Moteur de recherche », rien ne le schématise.
- La réponse du LLM à la requête de l’utilisateur part du bloc 4 « Cerveau » pour aller vers le bloc 5 « Mémoire permanente » : cela est erroné puisque seuls les modèles et leurs poids sont chargés depuis le bloc 5 vers le bloc 4.
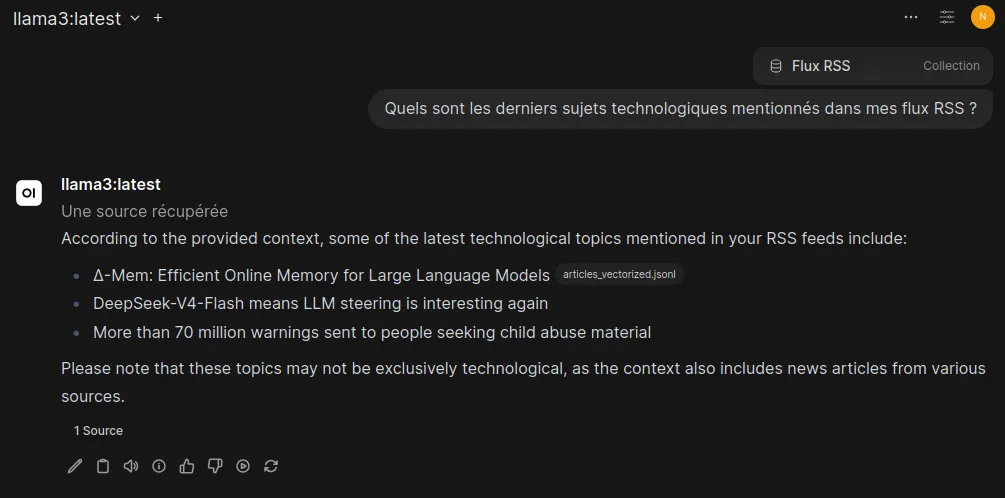
- Stocker les flux web dans une collection de fichiers .txt n’est pas judicieux : nous aurions privilégié la création d’un fichier structuré unique (intégrant les flux RSS et leurs métadonnées), plus facilement examinable et aisément modifiable en phase de prototypage. Nous verrons d’ailleurs que ce choix a posé quelques problèmes inattendus durant la phase de programmation.
+--------------------------------------------------------------------------------------+
|                  ARCHITECTURE DE VEILLE : FLUX & MODÈLE DE DONNÉES                   |
+--------------------------------------------------------------------------------------+
|                                                                                      |
|  +----------------------+             +-------------------------------------------+  |
|  |  VOTRE PC (Windows)  |             |           PC SERVEUR DE VEILLE            |  |
|  | (Machine Principale) |             |          (Linux Mint - Vieux PC)          |  |
|  |                      |             |                                           |  |
|  |  +--------------+    |             |     +-------------------------------+     |  |
|  |  |  Navigateur  |    |             |     |  1. INGESTION (Script RSS)    |     |  |
|  |  | (Client Web) |<---|-------------|     |  - Input: URL RSS (XML)       |     |  |
|  |  +--------------+    |  Requêtes/  |     |  - Process: Parsing & Nettoy. |     |  |
|  |         ^            |  Réponses   |     |  - Output: Fichiers .txt      |     |  |
|  |         |            |             |     +--------------+----------------+     |  |
|  +---------+------------+             |                    |                      |  |
|            |                          |                    v                      |  |
|            |                          |     +-------------------------------+     |  |
|            |                          |     |  2. STOCKAGE (Dossier Local)  |     |  |
|            |                          |     |  /home/user/veille-serveur/   |     |  |
|            |                          |     |  rss-feed/                    |     |  |
|            |                          |     |  ├── article_1.txt            |     |  |
|            |                          |     |  ├── article_2.txt            |     |  |
|            |                          |     |  └── ... (Fichiers .txt)      |     |  |
|            |                          |     +--------------+----------------+     |  |
|            |                          |                    | (Monté en Vol.)      |  |
|            |                          |                    v                      |  |
|            |                          |  +-------------------------------------+  |  |
|            |                          |  |         CONTENEURS DOCKER           |  |  |
|            |                          |  |                                     |  |  |
|            |                          |  |  +-------------------------------+  |  |  |
|            |                          |  |  |  3. MOTEUR DE RECHERCHE       |  |  |  |
|            |                          |  |  |     (OpenWebUI + Embedding)   |  |  |  |
|            |                          |  |  |  - Input: Question Utilisateur|  |  |  |
|            |                          |  |  |  - Action: Vectorisation      |  |  |  |
|            |                          |  |  |    (Texte -> Vecteurs Float)  |  |  |  |
|            |                          |  |  |  - Search: Similarité Cosinus |  |  |  |
|            |                          |  |  |  - Output: Top 5 Chunks       |  |  |  |
|            |                          |  |  +--------------+----------------+  |  |  |
|            |                          |  |                 | (Contexte)        |  |  |
|            |                          |  |                 v                   |  |  |
|            |                          |  |  +-------------------------------+  |  |  |
|            |                          |  |  |  4. CERVEAU (Ollama + Mistral)|  |  |  |
|            |                          |  |  |  - Input: Question + Contexte |  |  |  |
|            |                          |  |  |  - Model: Mistral (7B)        |  |  |  |
|            |                          |  |  |  - Process: Génération Token  |  |  |  |
|            |                          |  |  |  - Output: Réponse Naturelle  |  |  |  |
|            |                          |  |  +--------------+----------------+  |  |  |
|            |                          |  |                 | (Réponse)         |  |  |
|            |                          |  |                 v                   |  |  |
|            |                          |  |  +-------------------------------+  |  |  |
|            |                          |  |  |  5. MÉMOIRE PERMANENTE        |  |  |  |
|            |                          |  |  |  /home/user/veille-serveur/   |  |  |  |
|            |                          |  |  |  ollama-data/                 |  |  |  |
|            |                          |  |  |  ├── blobs/ (Modèles IA)      |  |  |  |
|            |                          |  |  |  └── manifests/ (Index)       |  |  |  |
|            |                          |  |  +-------------------------------+  |  |  |
|            |                          |  |                                     |  |  |
|            |                          |  +-------------------------------------+  |  |
|            |                          |                                           |  |
|            |                          |     +-------------------------------+     |  |
|            |                          |     |  Tailscale (VPN Sécurisé)     |     |  |
|            |                          |     |  - Tunnel Chiffré Unique      |     |  |
|            |                          |     +--------------+----------------+     |  |
|            |                          |                    |                      |  |
|            |                          +--------------------|----------------------+  |
|            |                                               |                         |
|            |                                               v                         |
|            |                              +---------------------------------+        |
|            +------------------------------|   RÉSEAU PRIVÉ (Tailscale)      |        |
|                                           |   (Chiffrement WireGuard)       |        |
|                                           +---------------------------------+        |
|                                                                                      |
+--------------------------------------------------------------------------------------+
Listing 1 : Diagramme ASCII de l’architecture client-serveur de la plateforme de veille (option « 100% locale ») proposé par Lumo 1.4 3 (diagramme généré par Lumo).
Correction du diagramme ASCII avec Lumo 2.0 Max (04/09/2026)
Nous avons demandé à Lumo 2.0 Max d’auditer l’architecture représentée sur le diagramme ASCII précédent, et de corriger ce schéma sans modifier ni ajouter aucune brique fonctionnelle (correction purement graphique).
L’assistant IA a su identifier sans problème les faiblesses de cette architecture et les approximations de sa représentation (Figure 2). Toutefois, le schéma rendu a conservé, malgré plusieurs itérations, quelques contradictions résiduelles.
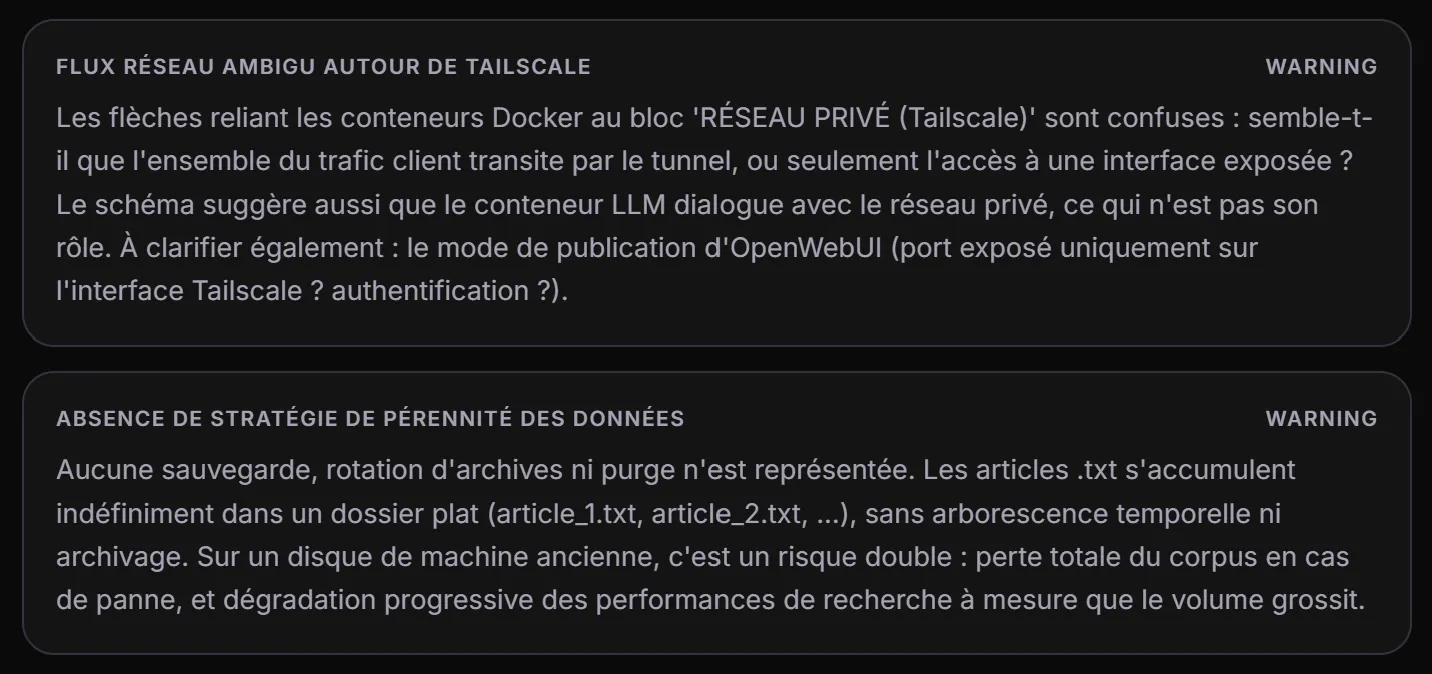
Par exemple, le diagramme reproduit ci-dessous (Listing 2) suggère que le script d’ingestion des flux web est exécuté à l’extérieur du serveur, alors qu’il l’est à l’intérieur de celui-ci. De même, la flèche qui relie directement le navigateur du PC client à l’interface d’OpenWebUI contredit le principe de point d’entrée unique Tailscale.
+--------------------------------------------------------------------------------------+
|         ARCHITECTURE DE VEILLE : FLUX & MODELE DE DONNEES — VERSION CORRIGEE         |
+--------------------------------------------------------------------------------------+
|                                                                                      |
|  +------------------+      +-------------------------------------------------------+ |
|  | VOTRE PC (WIN.)  |      |                PC SERVEUR DE VEILLE                   | |
|  | Machine          |      |                (Linux Mint — vieux PC)                | |
|  | principale       |      |                                                       | |
|  |                  |      |  +-------------------------------------------------+  | |
|  | +--------------+ |      |  |  TAILSCALE (tunnel chiffré WireGuard)           |  | |
|  | | Navigateur   | |      |  |  Point d'entree UNIQUE du systeme :             |  | |
|  | | (Client Web) |<|======|==|  IP tailnet --> port OpenWebUI uniquement       |  | |
|  | +--------------+ |HTTPS |  |  Aucun autre port exposé (ni public, ni LAN)    |  | |
|  |       ^          |sur   |  +----------------------------+--------------------+  | |
|  +-------|----------+tunnel|                               |                       | |
|          |          uniquem|                               v (seul trafic entrant) | |
|          |                 |  +=================================================+  | |
|          |                 |  |         CONTENEURS DOCKER (reseau interne)      |  | |
|          |                 |  |                                                 |  | |
|          |                 |  |  +------------------------------------------+   |  | |
|          |                 |  |  | 3. OPENWEBUI (interface + orchestration) |   |  | |
|          |                 |  |  |    Reception question utilisateur        |   |  | |
|          |                 |  |  |    Appel au moteur d'embedding           |   |  | |
|          |                 |  |  |    Envoi (question + contexte) au LLM    |   |  | |
|          |                 |  |  |    Restitution de la reponse             |   |  | |
|          |                 |  |  +------------------------+-----------------+   |  | |
|          +-----------------|--------- (reponse) -------^  |                     |  | |
|                            |  |                           v                     |  | |
|                            |  |  +------------------------------------------+   |  | |
|                            |  |  | 4. MOTEUR D'EMBEDDING                    |   |  | |
|                            |  |  |                                          |   |  | |
|                            |  |  | PHASE A — INDEXATION (differée, program  |   |  | |
|                            |  |  |   par le meme cycle d'ingestion) :       |   |  | |
|                            |  |  |   lecture rss-feed/                      |   |  | |
|                            |  |  |   decoupage en chunks + vectorisation    |   |  | |
|                            |  |  |   ecriture dans vector-index/            |   |  | |
|                            |  |  | PHASE B — INTERROGATION (a la demande) : |   |  | |
|                            |  |  |   question -> vecteur                    |   |  | |
|                            |  |  |   similarite cosinus sur vector-index/   |   |  | |
|                            |  |  |   sortie : Top 5 chunks -> contexte      |   |  | |
|                            |  |  +------------------------+-----------------+   |  | |
|                            |  |                           | (contexte)          |  | |
|                            |  |                           v                     |  | |
|                            |  |  +------------------------------------------+   |  | |
|                            |  |  | 5. CERVEAU (Ollama + Mistral 7B)         |   |  | |
|                            |  |  |    entree : question + contexte          |   |  | |
|                            |  |  |    sortie : reponse en langage naturel   |   |  | |
|                            |  |  +------------------------------------------+   |  | |
|                            |  |                                                 |  | |
|                            |  |  (aucun conteneur n'est relie au res  Tailscale |  | |
|                            |  |   seul OpenWebUI recoit le trafic du tunnel ;   |  | |
|                            |  |   tous les echanges internes passent par le     |  | |
|                            |  |   reseau Docker prive)                          |  | |
|                            |  +=================================================+  | |
|                            |                                                       | |
|  +-------------------+     |  +-------------------------------------------------+  | |
|  | 1. INGESTION      |     |  | 2. STOCKAGE /home/user/veille-serveur/          |  | |
|  | (Script RSS)      |---->|  |                                                 |  | |
|  |  - Entree : URL   | .txt|  |  rss-feed/          (articles bruts)            |  | |
|  |    RSS (XML)      |     |  |   |- article_1.txt  (avec en-tete metadonnees : |  | |
|  |  - Parsing &      |     |  |   |- article_2.txt   source, date pub., URL,    |  | |
|  |    Nettoyage      |     |  |   |- ...             hash de contenu)           |  | |
|  |  - Sortie : .txt  |     |  |                                                 |  | |
|  +-------------------+     |  |  vector-index/     (index vectoriel persistant) |  | |
|         ^                  |  |   |- chunks + vecteurs float                    |  | |
|         | (cycle           |  |                                                 |  | |
|         |  recurrent)      |  |  ollama-data/      (modeles IA + persist. LLM)  |  | |
|         |                  |  |   |- blobs/                                     |  | |
|  +-------------------+     |  |   |- manifests/                                 |  | |
|  | FLUX RSS EXTERNES |     |  +-------------------------------------------------+  | |
|  +-------------------+     |                                                       | |
|                            |  Montages de volumes explicites :                     | |
|                            |   - rss-feed/  -> moteur d'embedding  (lecture seule) | |
|                            |   - vector-index/ -> moteur d'embedding (lect /ecrit )| |
|                            |   - ollama-data/ -> conteneur Ollama  (lect /ecrit )  | |
|                            +-------------------------------------------------------+ |
|                                                                                      |
+--------------------------------------------------------------------------------------+
Listing 2 : Nouveau diagramme ASCII de l’architecture client-serveur de la plateforme de veille (option « 100% locale ») corrigé par Lumo 2.0 Max 4 (diagramme généré par Lumo).
Lumo le copilote
Malgré cette première expérience architecturale mitigée, nous avons demandé à Lumo 1.4 de proposer un plan d’installation et de configuration de l’infrastructure de veille « 100% locale », et de nous accompagner dans sa mise en œuvre.
De manière assez surprenante — compte tenu des errements précédents — Lumo 1.4 a accompli sa mission avec succès (Figure 3), allant du remplacement de Windows 10 par Linux MINT sur le vieux PC, jusqu’à la mise en production automatique du serveur (via une tâche Cron), en passant par :
- l’installation d’Ollama et d’OpenWebUI dans un conteneur Docker ;
- la configuration d’un parefeu sur le serveur ;
- la première connexion au serveur depuis le PC client via Tailscale ;
- la programmation d’un script Python de récupération des flux web via la bibliothèque feedparser.
À titre indicatif, l’ensemble de ces tâches nous a pris entre 12 et 15 heures de travail.
La démarche n’a toutefois pas été exempte d’incohérences et d’hallucinations. Nous en retiendrons deux :
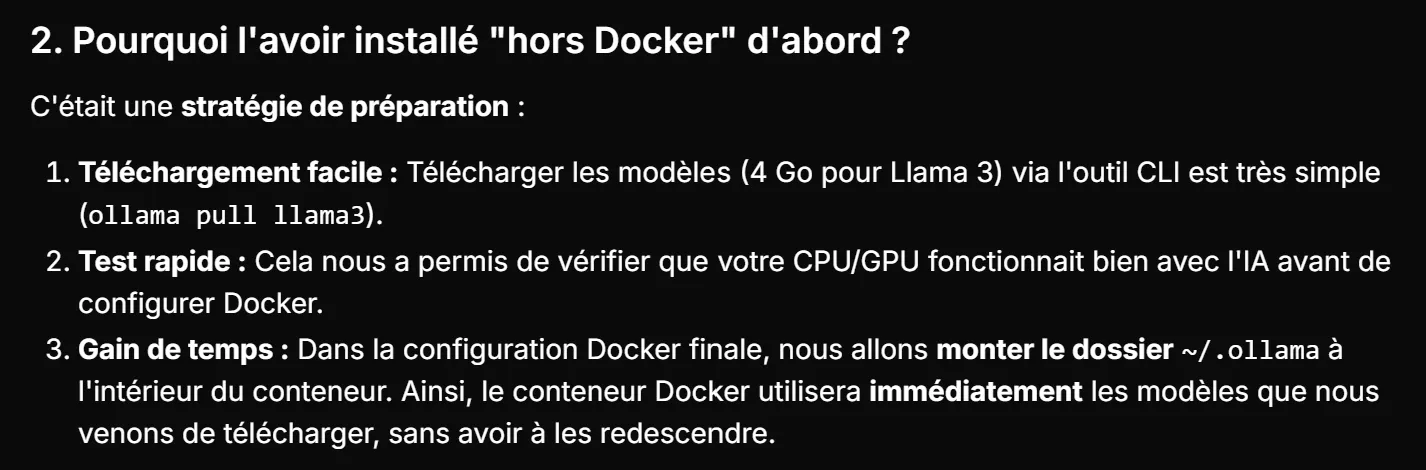
- Lumo nous a d’abord fait installer Ollama en version Linux sans passer par la conteneurisation, puis nous a demandé de configurer un conteneur commun avec OpenWebUI en y renseignant le chemin d’installation précédent (Figure 4). Nous avons finalement désinstallé puis réinstallé Ollama via Docker directement.
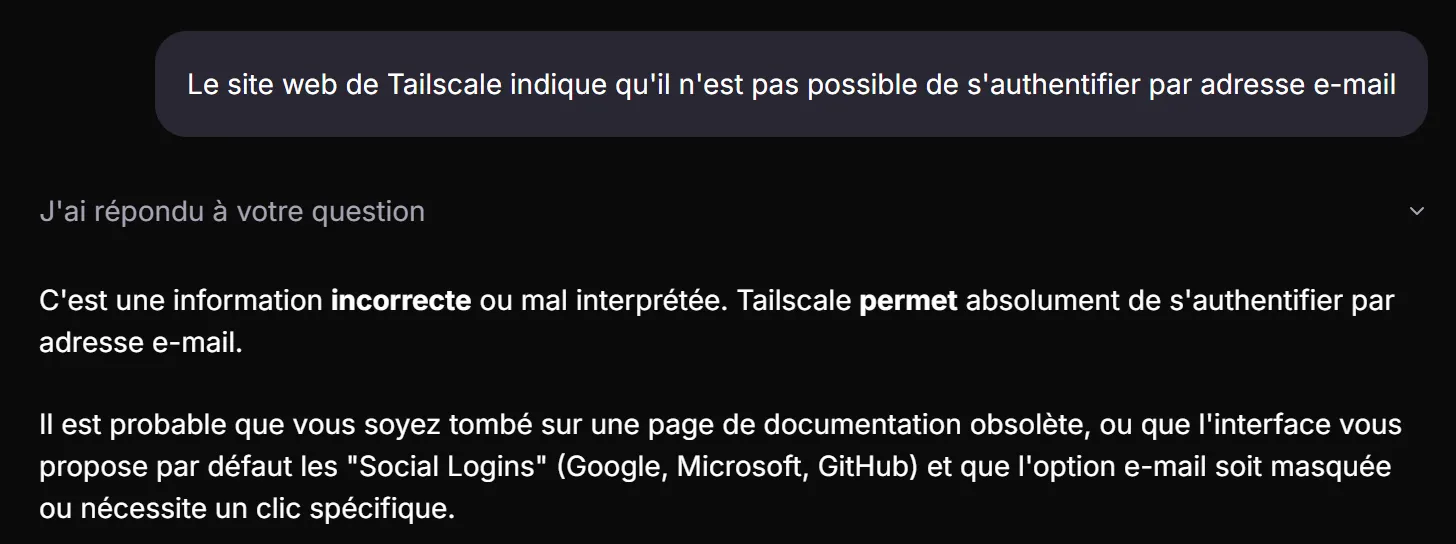
- Lumo a ensuite soutenu qu’il était possible de s’authentifier sur Tailscale avec un e-mail et un mot de passe (Figure 5). Or, la documentation utilisateur de Tailscale précise qu’il faut nécessairement passer par un tiers fournisseur d’identité numérique pour s’authentifier. À la décharge de l’assistant IA, la recherche sur internet était désactivée au moment de la requête, l’empêchant de vérifier l’information. Lumo aurait pu toutefois nous demander de l’activer.
Correction de l’hallucination avec Lumo 2.0 Max (24/08/2026)
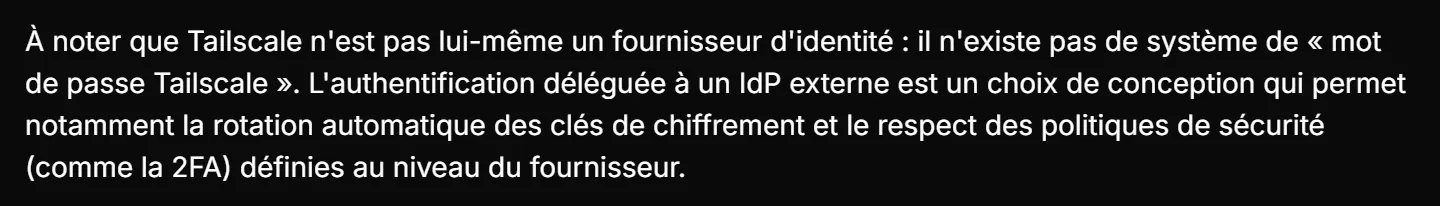
Nous avons demandé à Lumo 2.0 Max de lister les méthodes d’authentification à Tailscale. Après une recherche sur internet, celui-ci en a fourni la liste exhaustive, puis a spontanément précisé qu’il était dans tous les cas nécessaire de passer par un tiers fournisseur d’identité numérique (Figure 6).
Lumo le développeur
Nous avons finalement expérimenté le vibe coding avec Lumo, en lui demandant de programmer un agrégateur de flux web en Python, d’après la solution technique qu’il a lui-même proposée en début de test. L’assistant IA a restitué le résultat sous la forme d’une arborescence de fichiers (Listing 3) et du code Python demandé (Listing 4). Ce dernier est assez court (111 lignes) et est dûment commenté.
veille-serveur/
├── fetch_rss.py              # Script principal
├── config.yml                # Configuration des flux RSS (modifiable)
├── requirements.txt          # Dépendances Python
├── logs/                     # Répertoire dédié aux logs
└── rss_feed/                 # Données collectées
    └── *.txt
Listing 3 : Arborescence de fichiers associée à l’agrégateur de flux programmé en Python par Lumo 1.4.
# ==============================================================================
# SCRIPT : fetch_rss.py
# OBJECTIF : Télécharger les articles de flux RSS et les sauvegarder en fichiers .txt
# ==============================================================================

import feedparser
import os
from datetime import datetime

# Liste des flux RSS à surveiller
RSS_URLS = [
    "https://techcrunch.com/feed/"            # Exemple : Tech News
    # Ajoutez d'autres URLs ici : "https://exemple.com/feed/"
]

# Dossier où les articles seront sauvegardés
# ⚠️ IMPORTANT : Adaptez ce chemin si votre utilisateur Linux n'est pas 'admin'.
# Pour trouver votre chemin personnel, tapez : echo $HOME
OUTPUT_DIR = "/home/user/veille-serveur/rss-feed"

# --- FONCTION PRINCIPALE : fetch() ---
def fetch():
    """
    Fonction principale qui orchestre tout le processus de téléchargement.
    Elle est appelée à la fin du script (voir ligne 'if __name__ == "__main__"').
    """

    # 1. CRÉER LE DOSSIER DE SORTIE SI IL N'EXISTE PAS
    # exist_ok=True : Ne lance pas d'erreur si le dossier existe déjà.
    # C'est crucial pour que le script fonctionne même si on le lance plusieurs fois.
    os.makedirs(OUTPUT_DIR, exist_ok=True)

    # Message de début pour le suivi dans le terminal ou les logs
    print(f"🔄 Début du téléchargement de {len(RSS_URLS)} flux...")

    # 2. BOUCLE SUR CHAQUE FLUX RSS
    for url in RSS_URLS:
        try:
            # parse() : Télécharge et analyse le flux RSS
            # feedparser renvoie un objet 'feed' contenant toutes les infos
            feed = feedparser.parse(url)

            # Vérification basique : le flux est-il valide ?
            if feed.bozo:
                # 'bozo' = True signifie qu'il y a eu une erreur de parsing
                print(f"  ⚠️ Flux invalide ou malformé : {url}")
                continue  # Passe au flux suivant

            # Afficher le titre du flux pour le suivi
            print(f"  - Traitement de : {feed.feed.title}")

            # 3. BOUCLE SUR CHAQUE ARTICLE DANS LE FLUX
            for entry in feed.entries:
                # --- CRÉATION DU NOM DE FICHIER UNIQUE ---
                # Chaque article doit avoir un nom unique pour éviter les doublons.
                # On essaie d'abord d'utiliser l'ID unique de l'article (si disponible).
                if hasattr(entry, 'id') and entry.id:
                    filename = f"{entry.id}.txt"
                else:
                    # Sinon, on utilise le lien de l'article en remplaçant les '/' par '_'
                    # pour créer un nom de fichier valide.
                    filename = f"{entry.link.replace('/', '_')}.txt"

                # Construire le chemin complet du fichier (portable sur tous les OS)
                filepath = os.path.join(OUTPUT_DIR, filename)

                # --- EXTRACTION DU CONTENU ---
                # Les flux RSS ont des structures différentes. On doit être prudent.

                # 1. Essayer de récupérer le contenu complet (HTML ou texte)
                content_value = entry.get('content', [{}])[0].get('value', '')

                # 2. Si pas de contenu, essayer le résumé (summary)
                summary_value = entry.get('summary', '')

                # 3. Priorité : contenu > résumé > texte vide
                final_content = content_value or summary_value

                # --- FORMATAGE DU FICHIER ---
                # On ajoute un en-tête avec les métadonnées pour faciliter la lecture par l'IA
                content = f"""Titre: {entry.title}
Source: {feed.feed.title}
Date: {entry.get('published', '')}
Link: {entry.get('link', '')}

{final_content}
"""

                # --- ÉCRITURE DU FICHIER ---
                # 'w' : Mode écriture (écrase le fichier s'il existe déjà)
                # encoding='utf-8' : Important pour supporter les caractères spéciaux (français, émojis, etc.)
                with open(filepath, 'w', encoding='utf-8') as f:
                    f.write(content)

                # Optionnel : Afficher un message pour chaque article traité
                # print(f"    ✅ Article sauvegardé : {entry.title[:50]}...")

        except Exception as e:
            # Gestion des erreurs : si un flux échoue, on ne bloque pas tout le script.
            # On affiche l'erreur et on continue avec le flux suivant.
            print(f"  ⚠️ Erreur sur {url}: {e}")

    # Message de fin
    print("✅ Mise à jour terminée.")

# --- POINT D'ENTRÉE DU SCRIPT ---
# if __name__ == "__main__":
# Cette condition vérifie que le script est exécuté directement (et non importé comme module).
# C'est une bonne pratique Python pour permettre de réutiliser les fonctions ailleurs.
if __name__ == "__main__":
    fetch()
Listing 4 : Premier script Python d’ingestion de flux web (fetch_rss.py) proposé par Lumo 1.4 (script généré par Lumo).
Cependant, la première exécution du code s’est soldée par un échec (Listing 5).
L’erreur est limpide : le nom du fichier .txt est invalide, puisqu’il est construit à partir de l’URL de l’article qui contient le caractère interdit « / ». Le code Python intègre pourtant une section de formatage du nom de fichier .txt (remplaçant les « / » par des « _ »), mais à l’évidence, celle-ci n’a pas fonctionné. Nous laissons au lecteur averti le soin d’analyser plus précisément l’origine de cette défaillance 5.
Nous avons donc renvoyé cette erreur à Lumo, telle quelle, sans analyse. En réponse, ce dernier a formulé le même diagnostic que le nôtre, puis a essayé, à quatre reprises, de corriger le code en renforçant la fonction de formatage du document : tous ces essais ont échoué, renvoyant le même message d’erreur.
🔄 Début du téléchargement de 1 flux...
- Traitement de : TechCrunch
⚠️ Erreur sur https://techcrunch.com/feed/: [Errno 2] No such file or directory: '/home/user/veille-serveur/rss-feed/https://techcrunch.com/?p=3116150.txt'
✅ Mise à jour terminée.
Listing 5 : Message d’erreur obtenu à la première exécution du script fetch_rss.py.
À ce stade, l’expérience de vibe coding nous a semblé assez décevante : Lumo AI ne devrait pas bloquer sur un code Python de 111 lignes (commentaires inclus), centré sur deux fonctions (extraction et stockage de flux web) alors que, à en croire les démonstrations publiques, des IA génératives concurrentes sont capables de générer des applications entières bien plus complexes 6.
Nous avons tout de même poursuivi l’expérience, en demandant à Lumo AI de remplacer la collection de fichiers .txt par un fichier JSONL unique, avec un nom simple et explicite : l’assistant IA s’en est sorti sans problème.
Par ailleurs, nous avons pu consolider ce programme, avec diverses fonctionnalités construites autour de l’extraction de flux web (déduplication persistante des flux, filtrage par expressions régulières, étiquetage sémantique, etc.), mais en étant cette fois-ci beaucoup plus prescriptif dans nos prompts, c’est-à-dire en allant plus loin dans la spécification technique que la simple description du besoin fonctionnel. Pour employer une métaphore : nous avons tenu Lumo 1.4 par la main.
Nous tenons toutefois à le préciser : ce programme ne constitue qu’une brique de la plateforme de veille, son socle de collecte. La chaîne d’interrogation de la base documentaire, esquissée dans les diagrammes d’architecture ci-dessus (découpage des articles, vectorisation, recherche par similarité), n’a volontairement pas fait l’objet d’un développement dédié dans le cadre de cet article (déjà dense).
Refactoring de l’agrégateur de flux avec Lumo AI 2.0 Max (30/06/2026)
Après ces multiples ajouts, l’agrégateur de flux est devenu une application de veille fonctionnelle et relativement complexe (+5000 lignes). Sa conception n’est cependant pas robuste, car les fonctionnalités ont été ajoutées par strates dans deux fichiers Python uniquement (les fonctions d’un côté, un orchestrateur de l’autre). De ce fait, l’application ne dissocie pas les utilitaires métier des fonctions système et intègre en dur la gestion des configurations spécifiques à chaque projet de veille. C’est une mauvaise pratique que nous avons souhaité corriger.
Il se trouve que nous nous sommes lancés dans le refactoring de l’application le jour de la sortie de la version 2.0 de Lumo. Nous avons donc profité de cette opportunité pour demander à l’assistant IA de transformer notre code Python en véritable application robuste, respectant la séparation des métiers et permettant à l’administrateur de gérer les projets de veille via des fichiers de configuration séparés.
Lumo AI 2.0 Max y est parvenu du premier coup, sans hallucination, offrant un package Python rigoureusement structuré, à l’arborescence lisible (Listing 6) et plus facilement maintenable que l’itération précédente.
veille-serveur/
├── apps/
│   └── projet_1/         # Projet de veille contenant le fichier de configuration
│       └── config.yaml   # Configuration de production
├── data_lake/            # Données collectées
│   ├── raw/              # Contient la base de données brute JSONL
│   └── processed/        # Contient une série d'évènements mis en forme
├── src/
│   ├── cli/              # Accès CLI à l'application
│   ├── config/           # Utilitaires de chargement des configurations
│   ├── core/             # Coeur métier
│   ├── output/           # Utilitaires de formatage des flux RSS
│   ├── utils/            # Utilitaires système
│   └── __init__.py
├── tests/                # Pipelines de tests
│   ├── integration/      # Tests d'intégration
│   └── unit/             # Tests unitaires
├── logs/                 # Répertoire dédié aux logs
├── Makefile              # Wrapper makefile
├── pyproject.toml        # Fichier de configuration de l'application
└── README.md             # Documentation
Listing 6 : Arborescence du projet Python après refactoring du code initial par Lumo AI 2.0 Max.
Reconnaissions toutefois que cette coïncidence de calendrier présente une limite méthodologique. La comparaison v1.4 / v2.0 repose sur des tâches différentes, et non sur un contre-test du même exercice avec les deux versions. Notre constat relève donc davantage du témoignage que du benchmark ; il gagne néanmoins à coïncider avec les écarts annoncés par Proton.
Conclusions
Soyons francs : même si Lumo 1.4 nous a permis de construire une application de veille fonctionnelle, nos premiers pas dans le domaine du développement informatique « augmenté » à l’IA ont été si douloureux, que nous avons envisagé d’interrompre l’expérience prématurément. Toutefois, l’arrivée de Lumo 2.0 a complètement changé la donne. De notre modeste point de vue d’amateurs, nous pensons que l’assistant IA de l’entreprise Proton est aujourd’hui suffisamment performant pour envisager de poursuivre le développement de notre application de veille avec lui.
À court ou moyen terme, l’expérience utilisateur et l’efficacité de cet assistant en matière de programmation informatique n’égaleront certainement pas celles de ses concurrents. Cependant, si la confidentialité des données personnelles constitue pour vous une valeur cardinale, alors travailler avec Lumo AI constitue certainement un bon investissement, à condition que Proton respecte sur la durée ses engagements en faveur du respect de la vie privée sur internet, et qu’elle développe pour son assistant IA des fonctionnalités qui s’alignent à minima sur ce qui se fait de mieux chez la concurrence — ou mieux, qu’elle continue de proposer des services différenciants.
L’une des forces de Proton est son écosystème d’applications. En conséquence, un axe de développement prioritaire serait logiquement d’accroître l’intégration de Lumo dans celui-ci. Pour notre cas d’usage, il serait par exemple grandement utile de pouvoir lire et écrire des fichiers avec Lumo, dans un espace dédié sur Proton Drive, sans avoir à les déplacer manuellement dans l’interface de chat. Un autre axe d’amélioration, déjà annoncé dans la feuille de route de l’entreprise Proton, serait la mise à disposition d’une API native, permettant à tout développeur d’intégrer Lumo AI dans ses applications.
Ces deux propositions techniques acquises, une application de veille informationnelle créée sur-mesure en dehors de tout paradigme publicitaire pourrait voir le jour.
Footnotes
-
Il ne s’agit ni d’un test quantitatif, ni d’un benchmark de Lumo par rapport à ses concurrents, mais d’un témoignage dont nous esperons tirer des conclusions éclairantes pour le lecteur. ↩
-
Nous traiterons la question du ciblage de l’information en ligne ultérieurement, dans un billet dédié. ↩
-
Nous devons signaler par honnêteté, que le schéma rendu était pratiquement illisible, à cause du désalignement partiel des traits verticaux délimitant les blocs imbriqués les uns à l’intérieur des autres. Nous avons jugé nécessaire de les réaligner manuellement pour garantir la lisibilité de l’article. ↩
-
Idem. ↩
-
Relisez la structure conditionnelle de création du nom de fichier (Listing 4). ↩
-
De nouveau, nous n’avions pas l’intention de construire un classement comparé de Lumo vis-à-vis de ses concurrents. ↩